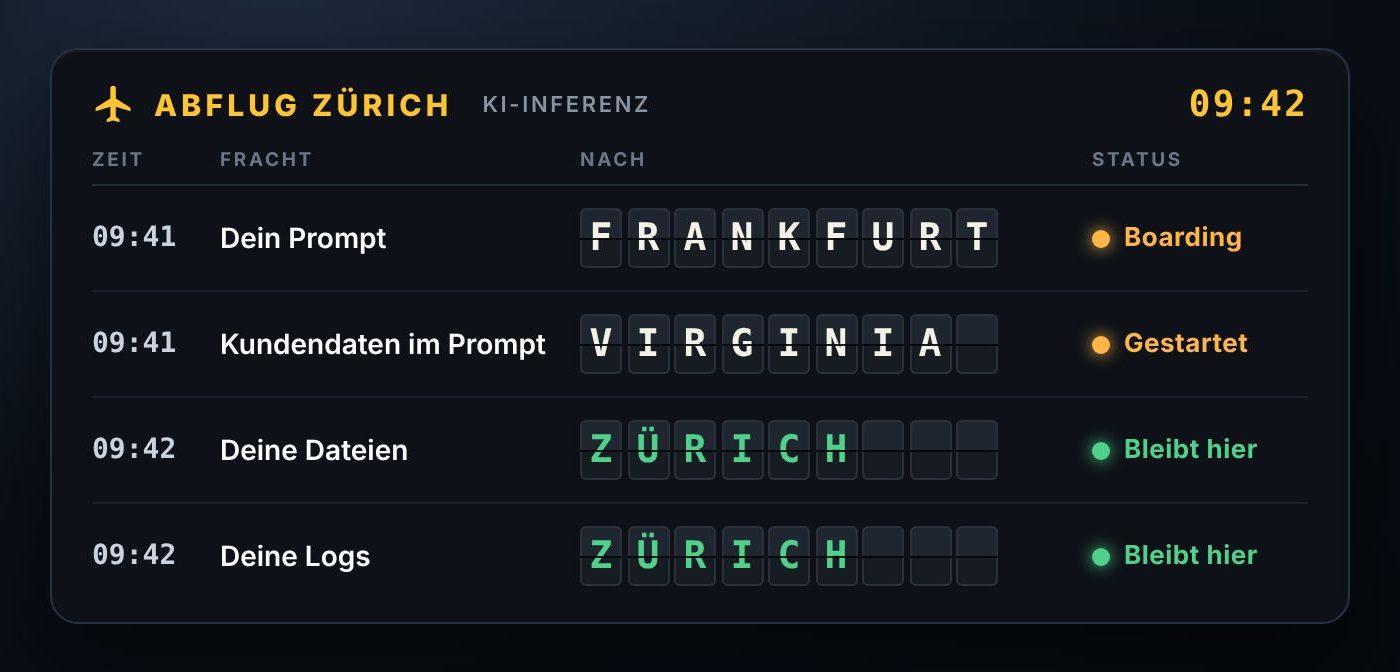
Immer wieder die gleiche Frage: Wo werden Daten gespeichert und verarbeitet? Bei KI hat das einen ganz anderen Stellenwert. Wer bei OCI, Azure oder AWS die Region Zürich wählt, speichert in der Schweiz. Gerechnet wird oft im Ausland, wo die GPUs stehen. Hier erfährst du, wo Daten die Schweiz verlassen und wie du das steuerst.
Gespeichert in Zürich, gerechnet woanders
Grundsätzlich war mir klar, wo KI-Daten verarbeitet werden. In den Medien liest man ständig von riesigen KI-Rechenzentren in den USA. Gerade deshalb sollten wir wissen, welche Möglichkeiten es für Speicherung und Verarbeitung in der Schweiz und in Europa gibt.
Ich spreche bewusst von Speicherung und Verarbeitung, denn Cloud-Anbieter trennen diese zwei Dinge. Der Speicherort ist der Ort, wo Dateien und Logs liegen. Der Verarbeitungsort ist der Ort, wo das Sprachmodell deine Anfrage beantwortet. Fachleute nennen das Inferenz. Sie braucht teure GPUs, und die stehen nicht in jeder Region zur Verfügung. Darum leiten die Anbieter Anfragen um:
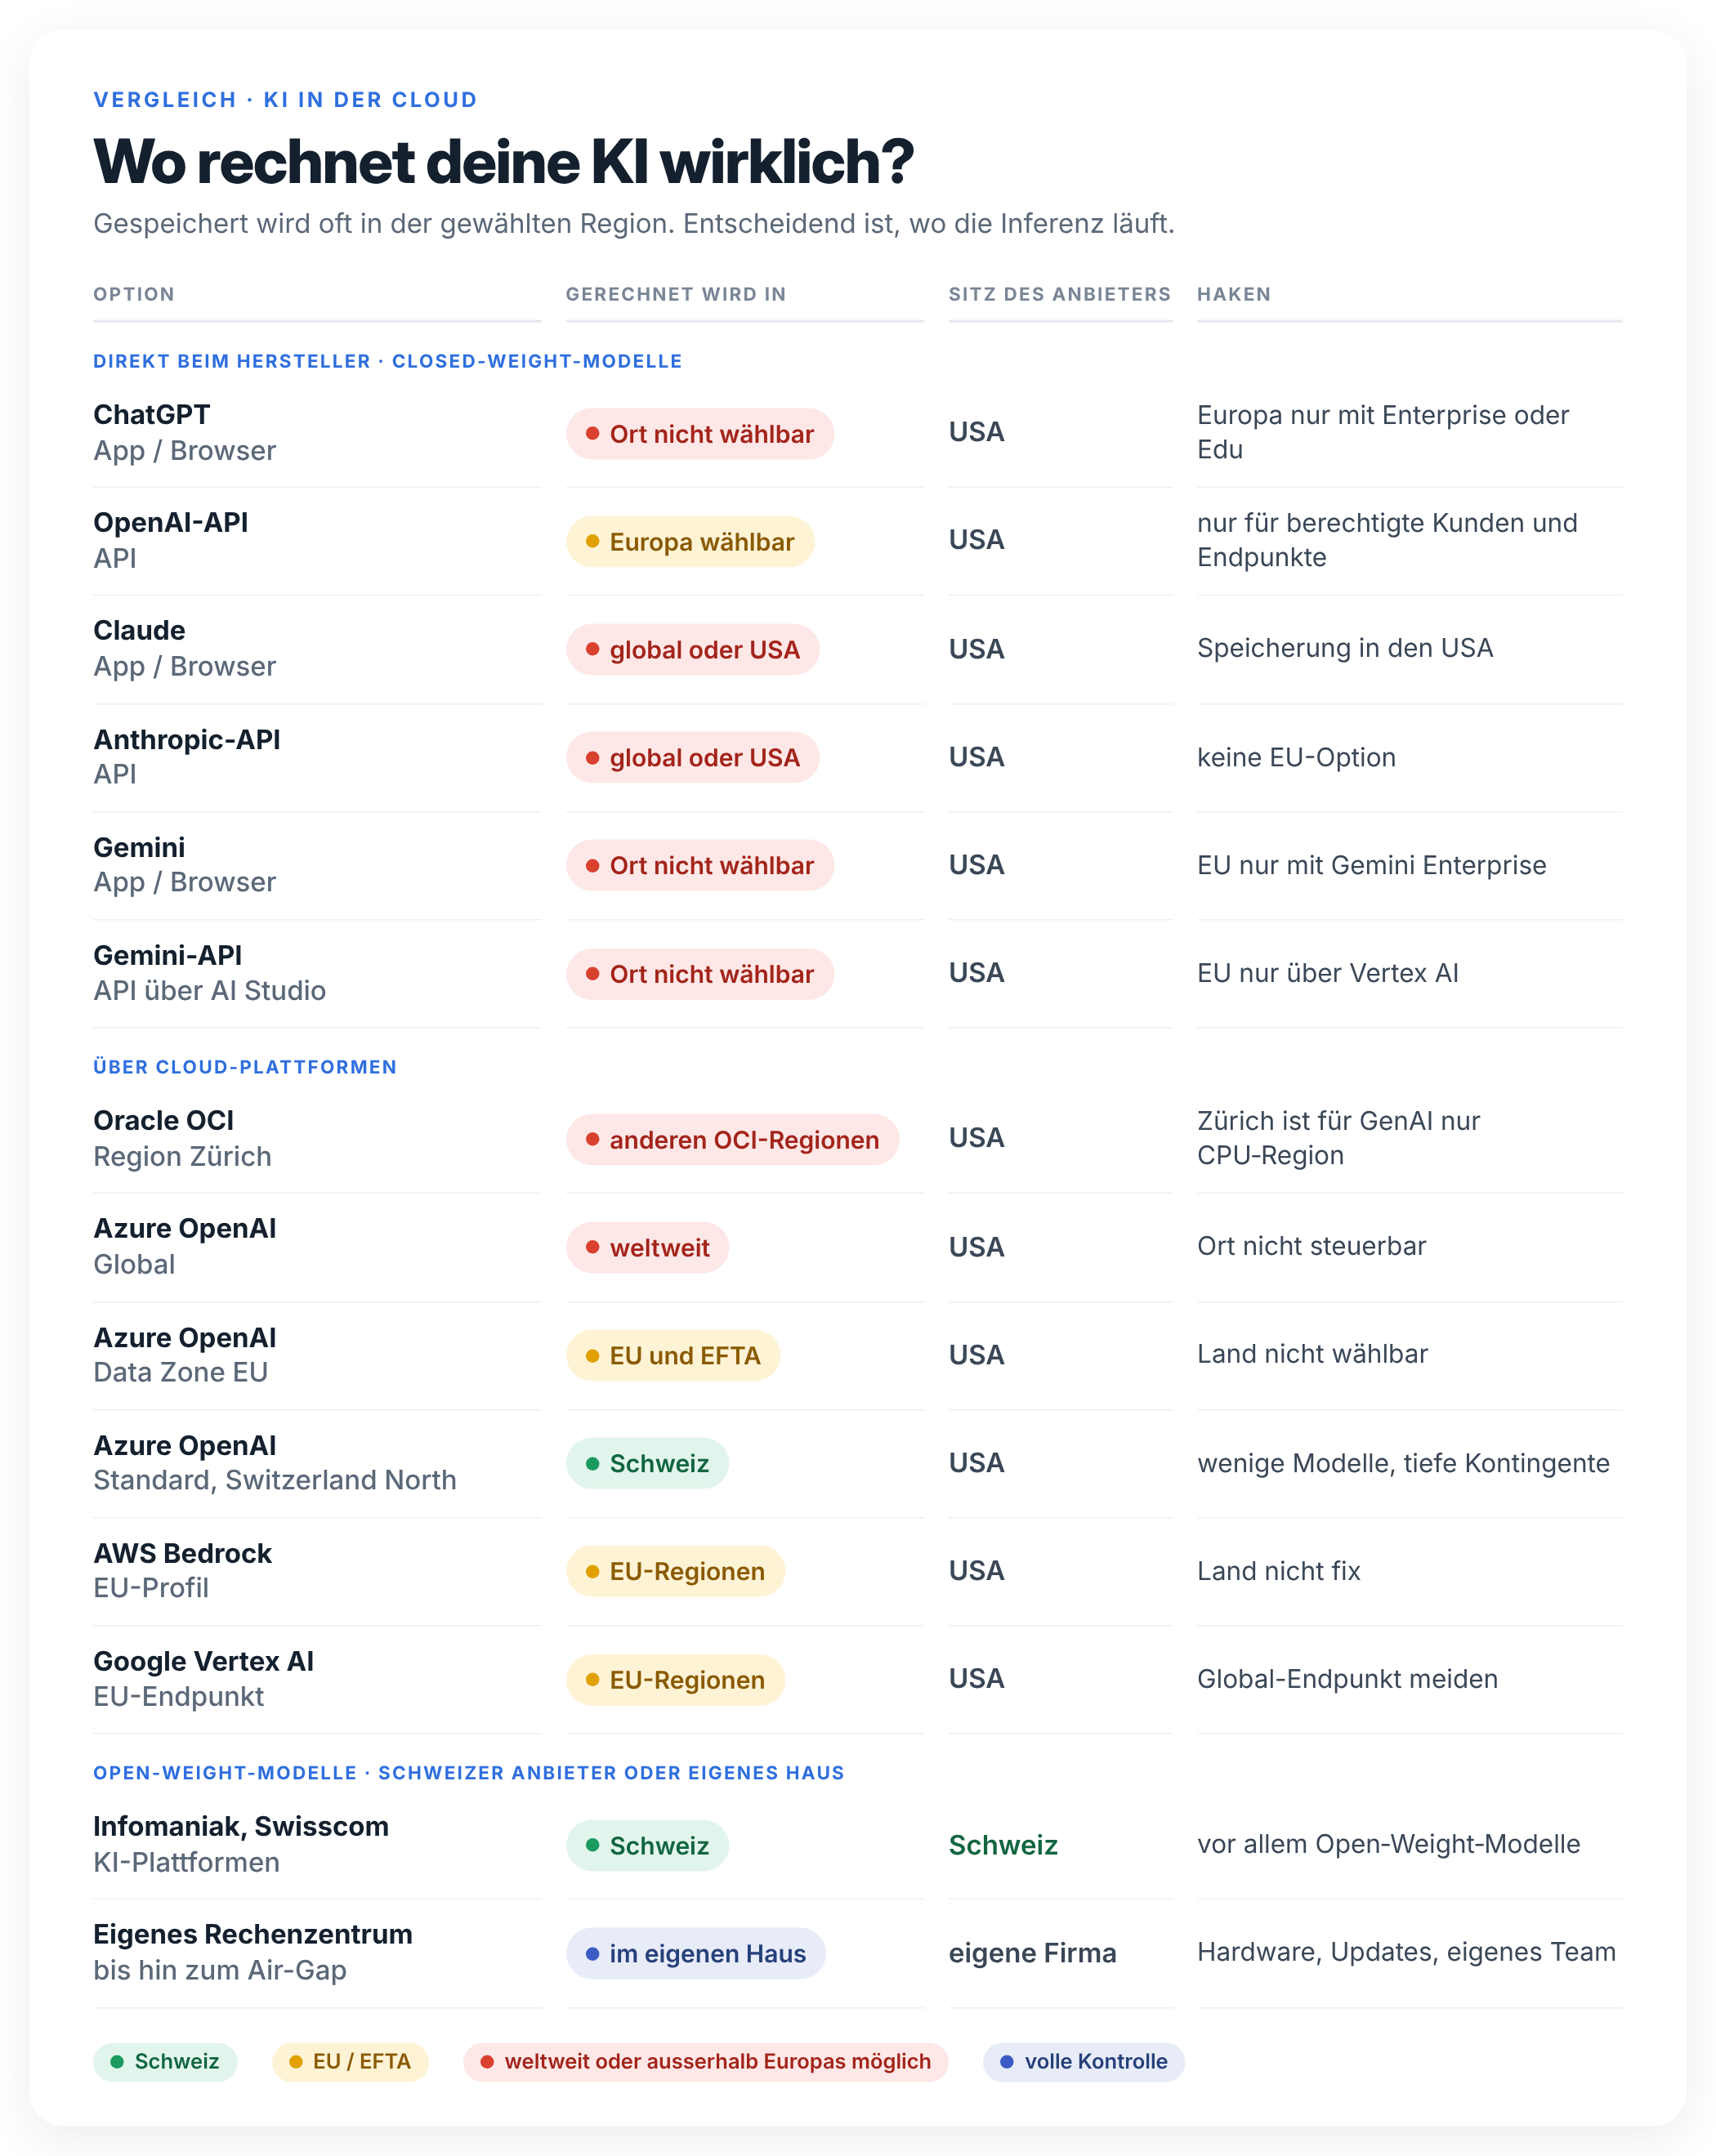
- Bei Oracle zählt Zürich für den Dienst Generative AI zu den CPU-only-Regionen. Die Modelle laufen in anderen Regionen.
- Bei Azure entscheidet der Deployment-Typ, wo gerechnet wird. Gespeichert wird in der Geografie der Ressource.
- Bei AWS Bedrock bleiben gespeicherte Daten in der Quellregion. Prompts und Antworten können sie per Cross-Region-Inferenz aber verlassen.
Die Regionsauswahl im Portal beruhigt. Mehr leistet sie nicht.
Gespeichert wird ja in Zürich!
Diesen Satz habe ich auch schon gehört. Genau hier liegt der Irrtum: Speicherung und Verarbeitung sind zwei Paar Schuhe. Für die Cloud-Architektur heisst das: Datenresidenz und Ort der Inferenz gehören als getrennte Anforderungen ins Design.
Fairerweise muss ich ergänzen: Flüchtige Inferenz mit vertraglicher Zero Data Retention ist deutlich risikoärmer als Daten, die dauerhaft beim Anbieter liegen. Gedanken machen solltest du dir trotzdem. Stecken Personendaten im Prompt, gilt schon die Verarbeitung im Ausland nach DSG als Bekanntgabe ins Ausland.
Gleiches Modell, anderer Weg, anderer Ort
Dasselbe Modell kann je nach Zugangsweg anderswo rechnen. Bei Claude können Firmen laut Anthropic über AWS Bedrock oder Google Vertex europäische Regionen wählen. Die direkte Anthropic-API kennt dagegen nur «global» und «us». Es zählt also auch der Weg zum Modell. Und wer ein einzelnes Land vorgeben muss, hat es schwer: Neue Claude-Modelle bietet AWS über Cross-Region-Profile an, nicht fest in einer Region.
Für OpenAI-Modelle gelten wieder andere Regeln. Mit Azure OpenAI und einem regionalen Standard-Deployment in Switzerland North wird nur in der Schweiz gerechnet. Der Haken: eingeschränkte Modellauswahl und tiefe Kontingente. Neue Modelle erscheinen zuerst global, dann in der Data Zone EU und zuletzt regional. Auch hier heisst es also: warten.
Lokale Anbieter oder Eigenbetrieb?
Neben Azure OpenAI gibt es Anbieter, die KI direkt in der Schweiz betreiben. Infomaniak und Swisscom stellen ihren Kunden Open-Weight-Modelle zur Verfügung, also Modelle mit frei verfügbaren Gewichten. So sparst du dir den eigenen Betrieb.
Je nachdem, wie heikel deine Daten sind, kommt auch ein lokaler Anbieter nicht infrage. Dann bleibt der Eigenbetrieb. Er verlangt Investitionen in Hardware, Software, Training und Feintuning, Security und Updates. Daraus kann schnell ein eigenes Team werden.
Drei Fragen, bevor du KI einführst
Für Unternehmen ist es wichtiger denn je, sich Gedanken zu KI zu machen. Und im gleichen Atemzug dazu, wo die Daten gespeichert und verarbeitet werden. Stell deinem Anbieter deshalb drei Fragen:
- Wo werden Prompts, Dateien und Logs gespeichert?
- Wo wird gerechnet? Frag nach dem Ort der Inferenz, nicht nach der Region im Portal.
- Kann ich die Verarbeitung auf eine bestimmte Region beschränken?
Die Antworten setzt du danach technisch durch, etwa mit Azure Policy oder einer AWS Service Control Policy. Nur so weisst du sicher, wo deine Daten landen.
Leider ist das alles wenig transparent. Ohne dich durch die Dokumentationen zu wühlen, findest du die Antworten kaum. Das ist Aufwand, aber einer, der sich lohnt.
Weiterführende Links
– OpenAI: Datenresidenz in Europa für API und ChatGPT Enterprise
– Google Cloud: Datenresidenz und ML-Verarbeitung in Vertex AI
– Microsoft: Was ist die EU Data Boundary
– Bundesamt für Justiz: Bericht zum US CLOUD Act
– Why “zero data retention” may not protect your business data
KI eingesetzt für:
Recherche-Unterstützung, Sprache/Korrektur, Bildgenerierung